

Expo
ver canal
ver canal
ver canal
ver canal
ver canal
ver canal
ver canal
ver canal
Química ClínicaDiagnóstico MolecularHematologíaInmunologíaMicrobiologíaPatologíaTecnologíaIndustria
Eventos
Webinars

- Anticuerpo en sangre se asocia con menos síntomas de depresión y TEPT tras lesión cerebral
- Biomarcador sanguíneo ayuda a monitorear respuesta temprana a lecanemab en Alzheimer
- Nuevo material de referencia busca mejorar la comparabilidad de las pruebas de angiotensina II
- Biomarcadores sanguíneos infantiles revelan riesgos cardíacos, renales y metabólicos tempranos
- Estudio de biomarcador sanguíneo revela señales tempranas de futuras dificultades cognitivas
- Método de análisis de ADN en sangre detecta cánceres sólidos en etapa temprana
- Análisis de proteínas en sangre ayuda a interpretar variantes inciertas de enfermedades raras
- Prueba sanguínea ayuda a aclarar el riesgo de cáncer de próstata tras PSA elevado
- Marcador genético común predice deterioro motor más rápido en la enfermedad de Parkinson
- Ensayo de genotipado DPYD ayuda a dosificar con mayor seguridad la quimioterapia con fluoropirimidinas
- Anemia limítrofe podría implicar mayor riesgo del que indican los umbrales actuales
- Un marco guiado por biomarcadores busca orientar el tratamiento del linfoma de células del manto
- Nuevos hallazgos genéticos revelan causa de síndrome de insuficiencia de médula ósea
- Dispositivo ultraportátil permite análisis de sangre por punción digital en el hogar
- Intervalos de referencia del hemograma por edad apoyan diagnóstico pediátrico en Vietnam
- Perfil inmunitario temporal revela cómo cambian los estados de sepsis con el tiempo
- Estudio identifica células inmunitarias que impulsan respuestas dañinas en COVID-19
- La “memoria” intestinal podría explicar por qué reaparecen los brotes de EII
- Perfil de anticuerpos basado en IA predice intensidad de respuesta a vacuna contra COVID-19
- Biomarcadores inmunitarios podrían predecir artritis recurrente por inhibidores de puntos de control
- Clasificador del microbioma intestinal mejora estratificación del riesgo de cáncer colorrectal
- Nuevo flujo de diagnóstico identifica patógenos sanguíneos y respuesta a antibióticos en horas
- Un marcador genético identifica resistencia emergente a fármacos antipalúdicos de primera línea
- Prueba de ADN libre circulante en plasma permite diagnóstico más temprano de infecciones fúngicas
- La FDA aprueba panel de una hora para detectar infecciones del torrente sanguíneo y resistencia antimicrobiana
- Nueva centrífuga multipropósito combina alta capacidad con refrigeración sostenible
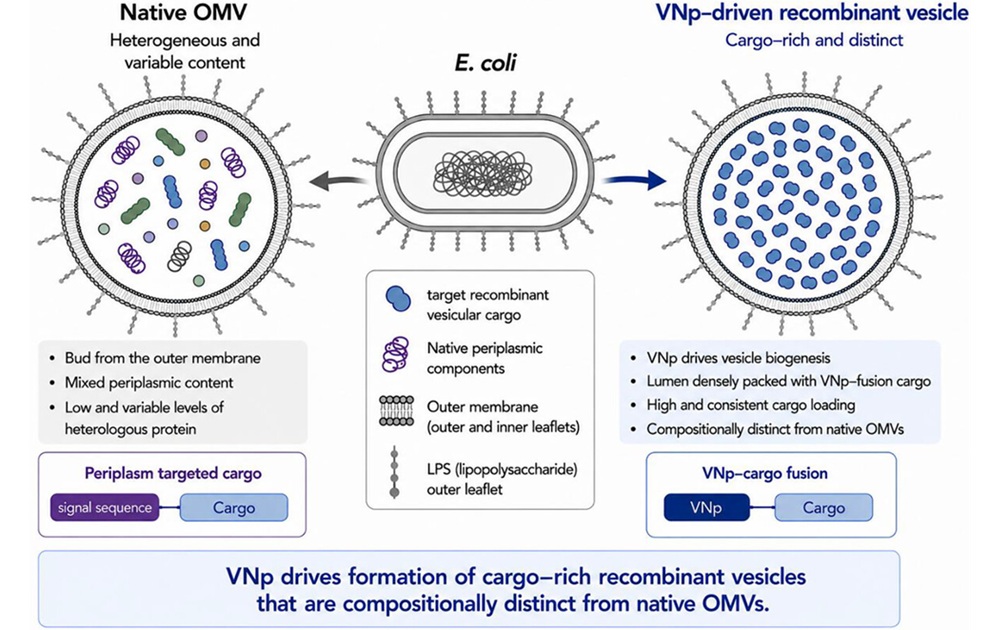
- Sistema de expresión con vesículas bacterianas agiliza producción de proteínas para diagnóstico del cáncer
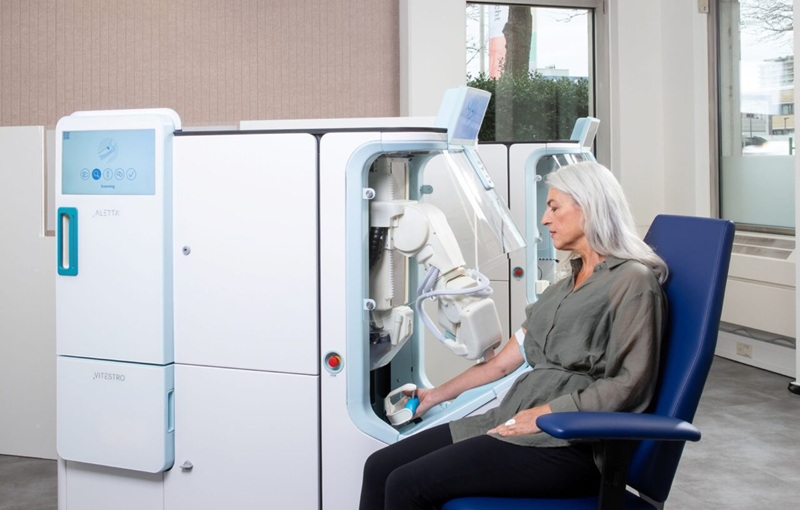
- Sistema robótico autónomo recibe autorización de la FDA para extracción de sangre
- Panel de algoritmos ayuda a evaluar la fibrosis hepática y vigilar el cáncer de hígado
- Los kits de detección enviados por correo ayudan a reducir brechas en el cribado del cáncer colorrectal
- Ensayos de biomarcadores neurológicos basados en sangre autorizados para su uso en Brasil
- Colaboración entre Sysmex y Cytek amplía el acceso a citometría de flujo clínica avanzada
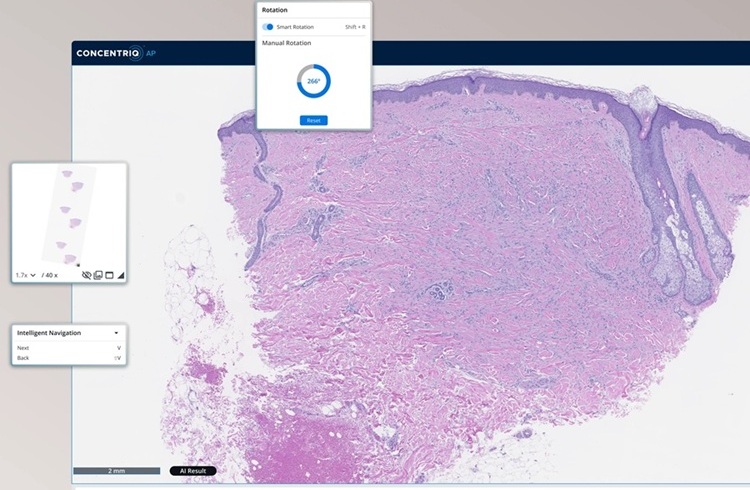
- Tecnología de tinción estandarizada mejora flujos de trabajo de patología digital
- Genprex y Roche colaboran en pruebas de biomarcadores de CPCNP impulsadas por IA
- Una colaboración impulsa los diagnósticos basados en esputo para el asma y la EPOC
- Método híbrido de imagenología computacional mejora la resolución de la patología digital
- Autorización de la FDA amplía las opciones de patología digital para los laboratorios clínicos
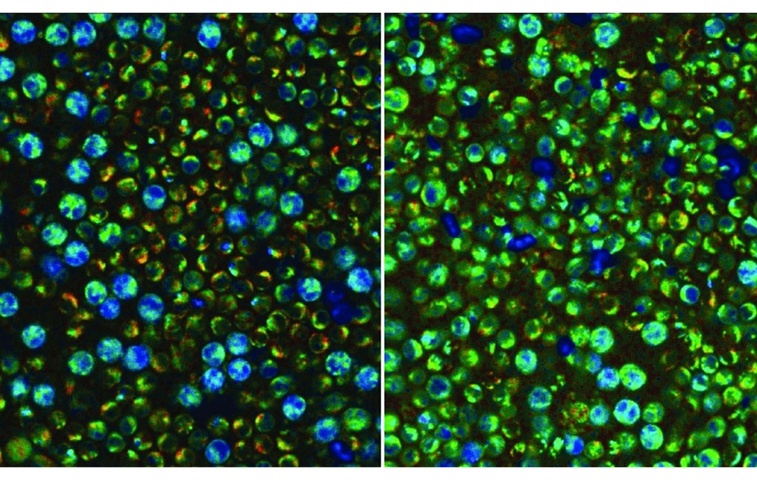
- Imágenes sin marcadores revelan actividad inmunitaria oculta en muestras de sangre
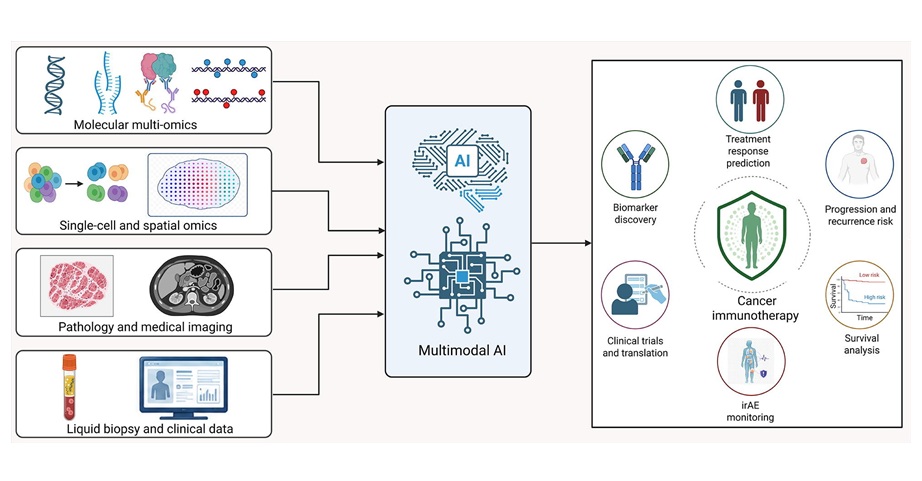
- IA mejora predicción de respuesta a inmunoterapia en cáncer de pulmón
- IA iguala a patólogos en predicción del pronóstico del cáncer de mama a partir de células inmunitarias
 Expo
- Anticuerpo en sangre se asocia con menos síntomas de depresión y TEPT tras lesión cerebral
- Biomarcador sanguíneo ayuda a monitorear respuesta temprana a lecanemab en Alzheimer
- Nuevo material de referencia busca mejorar la comparabilidad de las pruebas de angiotensina II
- Biomarcadores sanguíneos infantiles revelan riesgos cardíacos, renales y metabólicos tempranos
- Estudio de biomarcador sanguíneo revela señales tempranas de futuras dificultades cognitivas
- Método de análisis de ADN en sangre detecta cánceres sólidos en etapa temprana
- Análisis de proteínas en sangre ayuda a interpretar variantes inciertas de enfermedades raras
- Prueba sanguínea ayuda a aclarar el riesgo de cáncer de próstata tras PSA elevado
- Marcador genético común predice deterioro motor más rápido en la enfermedad de Parkinson
- Ensayo de genotipado DPYD ayuda a dosificar con mayor seguridad la quimioterapia con fluoropirimidinas
- Anemia limítrofe podría implicar mayor riesgo del que indican los umbrales actuales
- Un marco guiado por biomarcadores busca orientar el tratamiento del linfoma de células del manto
- Nuevos hallazgos genéticos revelan causa de síndrome de insuficiencia de médula ósea
- Dispositivo ultraportátil permite análisis de sangre por punción digital en el hogar
- Intervalos de referencia del hemograma por edad apoyan diagnóstico pediátrico en Vietnam
- Perfil inmunitario temporal revela cómo cambian los estados de sepsis con el tiempo
- Estudio identifica células inmunitarias que impulsan respuestas dañinas en COVID-19
- La “memoria” intestinal podría explicar por qué reaparecen los brotes de EII
- Perfil de anticuerpos basado en IA predice intensidad de respuesta a vacuna contra COVID-19
- Biomarcadores inmunitarios podrían predecir artritis recurrente por inhibidores de puntos de control
- Clasificador del microbioma intestinal mejora estratificación del riesgo de cáncer colorrectal
- Nuevo flujo de diagnóstico identifica patógenos sanguíneos y respuesta a antibióticos en horas
- Un marcador genético identifica resistencia emergente a fármacos antipalúdicos de primera línea
- Prueba de ADN libre circulante en plasma permite diagnóstico más temprano de infecciones fúngicas
- La FDA aprueba panel de una hora para detectar infecciones del torrente sanguíneo y resistencia antimicrobiana
- Nueva centrífuga multipropósito combina alta capacidad con refrigeración sostenible
- Sistema de expresión con vesículas bacterianas agiliza producción de proteínas para diagnóstico del cáncer
- Sistema robótico autónomo recibe autorización de la FDA para extracción de sangre
- Panel de algoritmos ayuda a evaluar la fibrosis hepática y vigilar el cáncer de hígado
- Los kits de detección enviados por correo ayudan a reducir brechas en el cribado del cáncer colorrectal
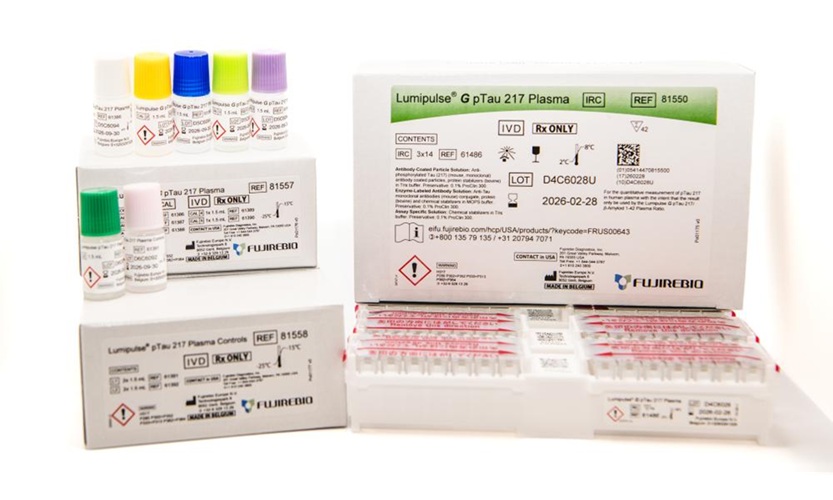
- Ensayos de biomarcadores neurológicos basados en sangre autorizados para su uso en Brasil
- Colaboración entre Sysmex y Cytek amplía el acceso a citometría de flujo clínica avanzada
- Tecnología de tinción estandarizada mejora flujos de trabajo de patología digital
- Genprex y Roche colaboran en pruebas de biomarcadores de CPCNP impulsadas por IA
- Una colaboración impulsa los diagnósticos basados en esputo para el asma y la EPOC
- Encuentran etiologías de COVID prolongada en muestras de sangre con infección aguda
- Dispositivo novedoso detecta anticuerpos contra la COVID-19 en cinco minutos
- Prueba para COVID-19 mediante CRISPR detecta SARS-CoV-2 en 30 minutos usando tijeras genéticas
- Asocian disbiosis del microbioma intestinal con la COVID-19
- Validan prueba rápida novedosa de antígeno para el SARS-CoV-2 con respecto a su exactitud diagnóstica
- Método híbrido de imagenología computacional mejora la resolución de la patología digital
- Autorización de la FDA amplía las opciones de patología digital para los laboratorios clínicos
- Imágenes sin marcadores revelan actividad inmunitaria oculta en muestras de sangre
- IA mejora predicción de respuesta a inmunoterapia en cáncer de pulmón
- IA iguala a patólogos en predicción del pronóstico del cáncer de mama a partir de células inmunitarias









 Ingresar cliente